❌

Normale Ansicht

„Who’s Afraid of Chinese Models?“

26. Juli 2026 um 16:17

Open-Weight-KI-Modelle bleiben teuer: Auch nach dem Training kostet jede einzelne Inferenz entsprechenden Rechenaufwand.
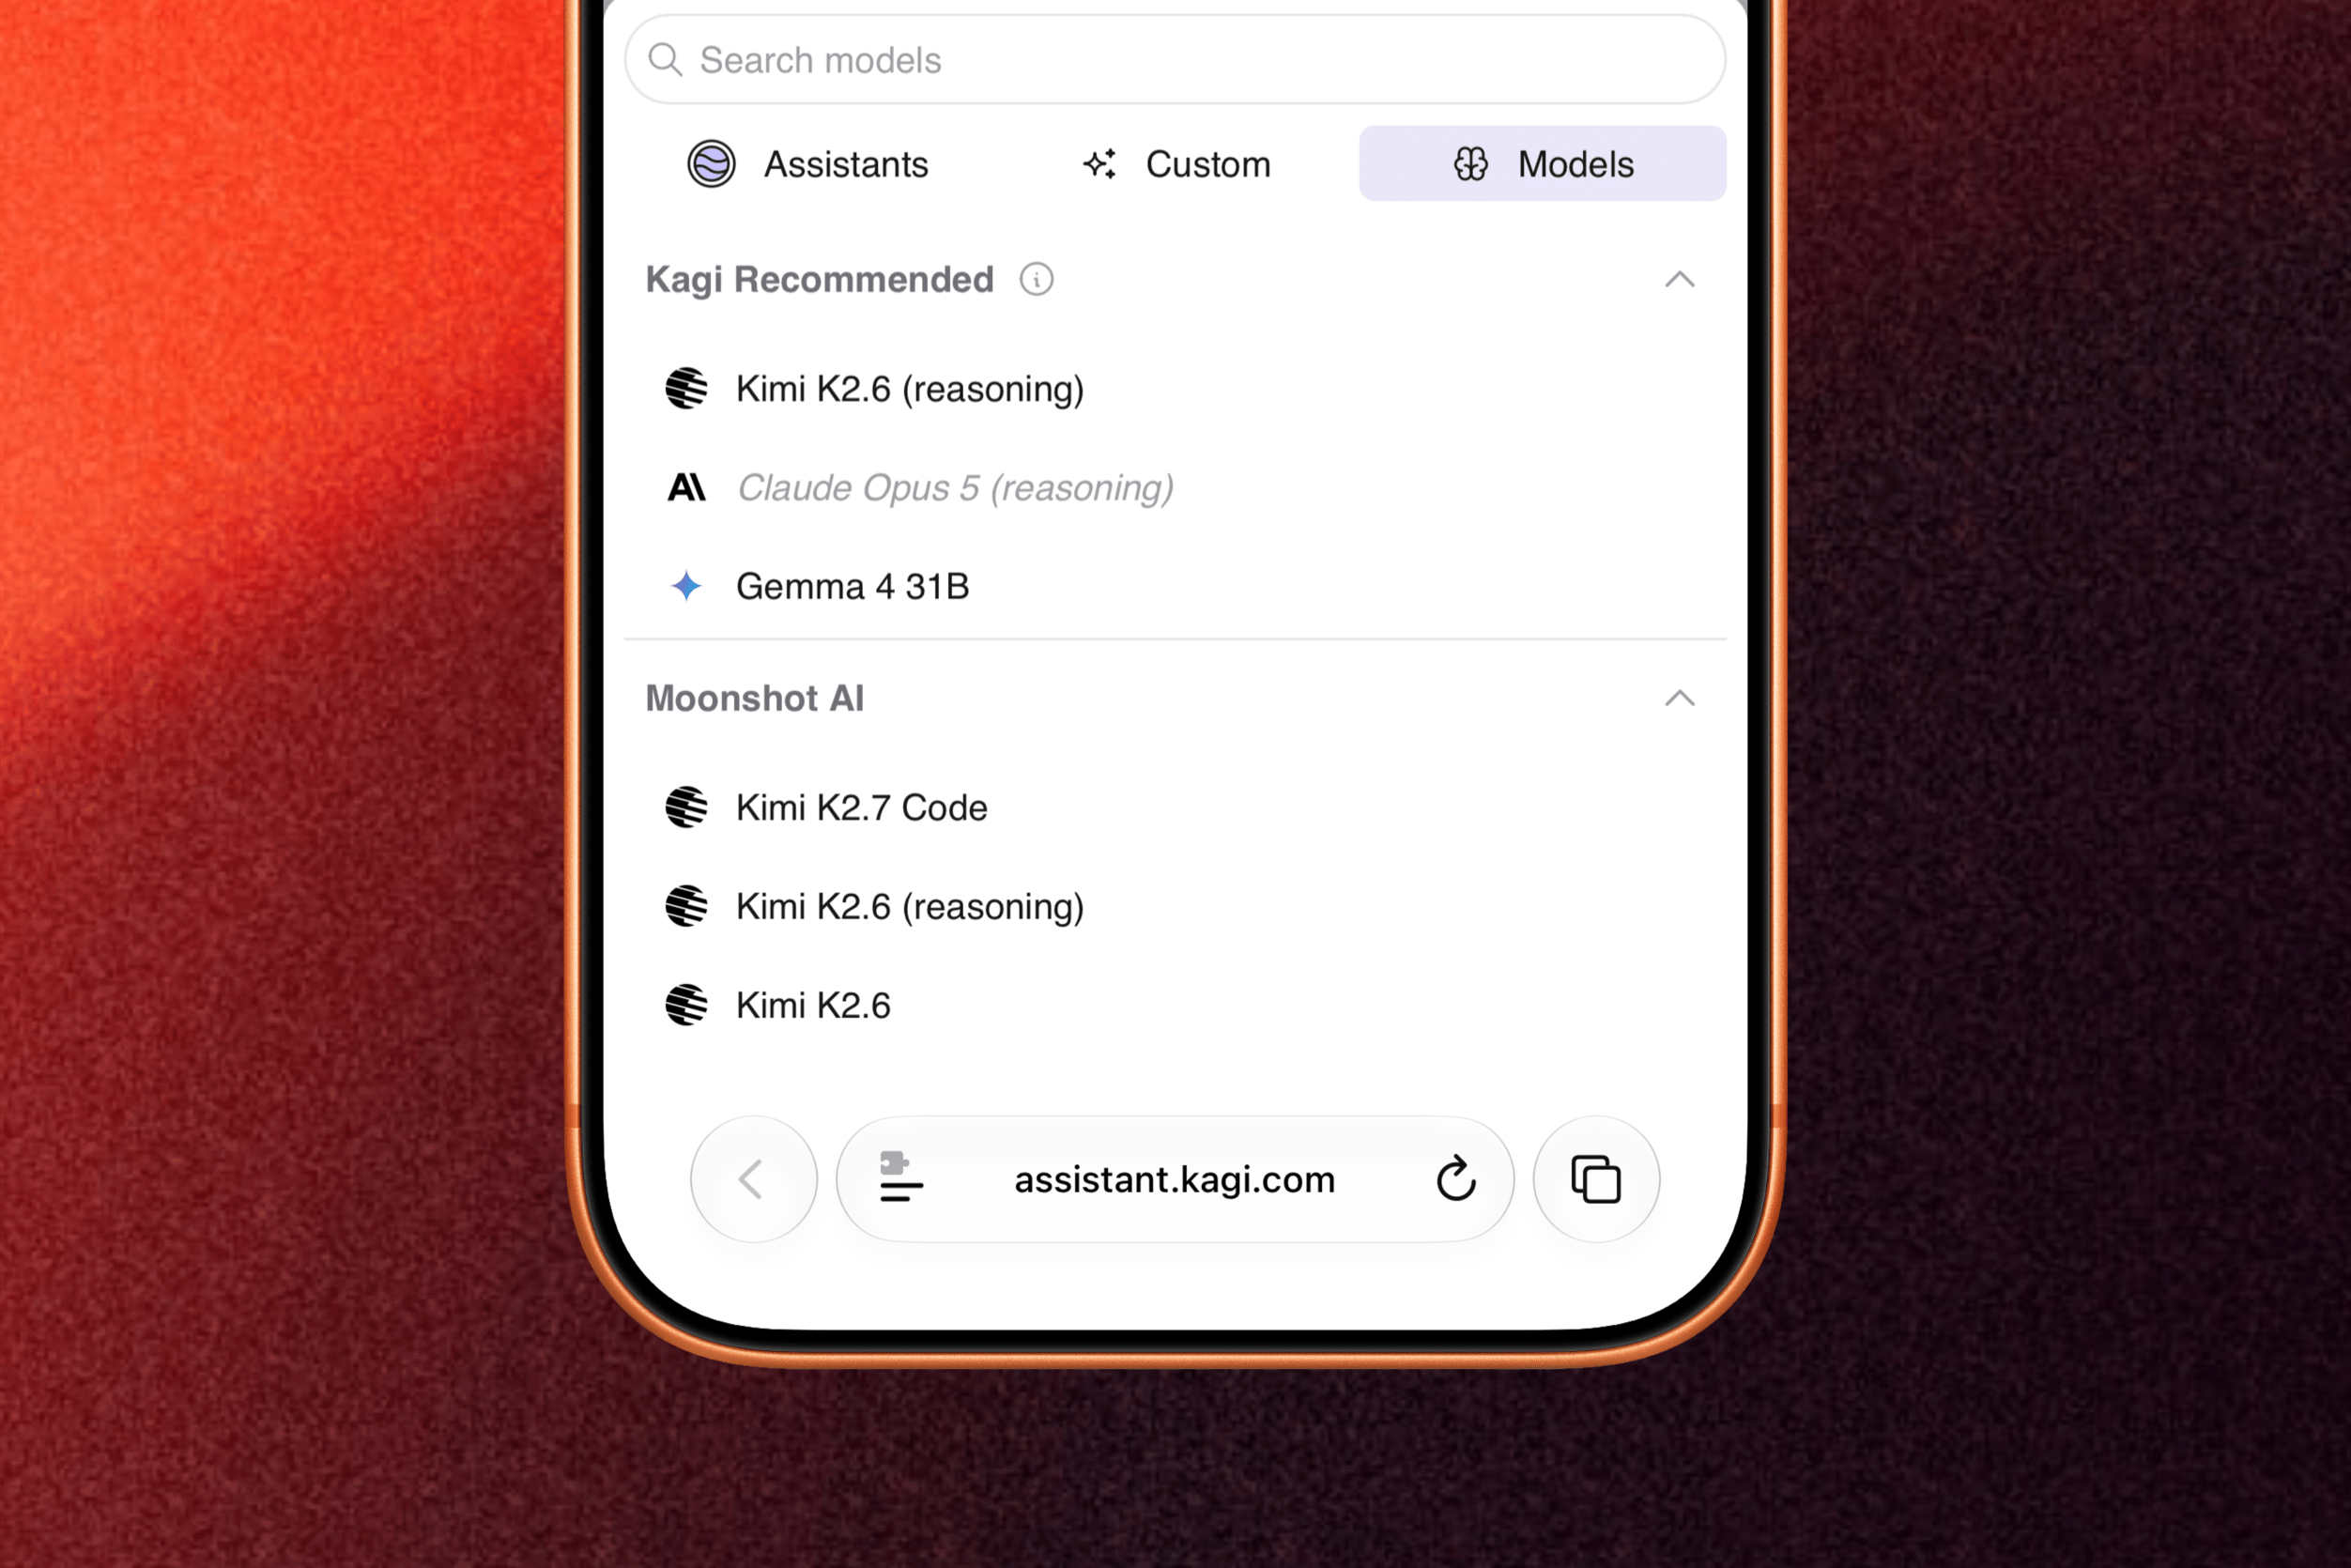
Ein Smartphone-Bildschirm zeigt eine Liste von KI-Modellen innerhalb einer Weboberfläche. Der Tab "Models" ist ausgewählt. Abschnitte umfassen "Kagi Recommended" mit "Kimi K2.6 (reasoning)", "Claude Opus 5 (reasoning)" und "Gemma 4 31B". Darunter befindet sich "Moonshot AI" mit "Kimi K2.7 Code", "Kimi K2.6 (reasoning)" und "Kimi K2.6". Unten zeigt eine Browserleiste die Adresse "assistant.kagi.com".

One of the most common misconceptions undergirding discussion of open weights models is that they are cheaper — free, even. After all, you can just download the weights, and skip the time and expense and capabilities necessary to create your own model. That is, of course, true, but the “free” in this case is a reference to the amount you need to spend on research and development; R&D is a fixed expense that is independent of the revenue you generate. […]

The point in terms of open weight models is that they are not free to serve. Kimi K3 costs $3 per million input tokens, and $15 per million output tokens; that is cheaper than Sol’s $5 per million input tokens and $30 per million output tokens, but that might not even be the right measurement.

Ben Thompson

Die Kosten verschwinden nicht, sie lassen sich aber teilweise aus der Cloud auf bereits verkaufte Hardware verlagern.

Mit intelligentem Routing zwischen unterschiedlichen Modellen haben iPhone-Kund:innen eine solche Rechenleistung bereits gekauft – in Form von Prozessor, Arbeitsspeicher, Speicherplatz und Neural Engine. Nur Strom muss fortlaufend bezahlt werden. Es ist keine kostenlose Intelligenz, sondern eher eine „Prepaid Intelligence“: ein teilweise im Gerätepreis enthaltener „local first, cloud when necessary“-Ansatz.

Offene Modelle verändern die Wettbewerbsbedingungen in einem Markt, den Apple mit seiner Verbindung aus Hardware, Software und Services traditionell erfolgreich besetzt. Die Herausforderung ist die flexible Einbindung leistungsfähiger Modelle in den persönlichen Kontext, ihre Berechtigungen klar zu begrenzen und sie für appübergreifende Funktionen vorzubereiten.

Ironisch: Die vom Digital Markets Act implizierte iOS-Öffnung für konkurrierende KI-Modelle könnte Apples Position im Markt für seine Hardware paradoxerweise stärken – solange iOS die zentrale Orchestrierungsebene bleibt und entscheidet, welches Modell wann, wo und mit welchen Daten zum Einsatz kommt.

Kontrolliert Apple diese Koordinationsschicht jedoch nicht, besteht das Risiko, dass iOS als Betriebssystem austauschbar wird. Allein diese Gefahr würde den Start von Siri AI in der EU dauerhaft verhindern.

  •  

Tastatur, Maus – nun Stimme.

16. Juli 2026 um 22:26

Wispr Flow, Willow Voice oder „Dictation“ von Voicenotes: Sprache entwickelte sich quasi über Nacht zu einem neuen Eingabegerät für Computer – auf Augenhöhe mit Tastatur und Maus. Sie ist nicht neu, aber in puncto Latenz, kontextueller Einordnung sowie sprachlicher Bereinigung plötzlich mehr als ein Diktat.

GPT‑Live ist erschreckend gut; Apples „Advanced Dictation“ in der Beta von iOS 27 hält da noch nicht mit, liefert aber ausdrucksvolle Stimmen.

Noch existieren qualitative Unterschiede zwischen den verschiedenen Angeboten. Alle verbessern sich jedoch rasant, und es ist nur eine Frage der Zeit, bis integrierte Systemfeatures übernehmen und die dedizierten Apps verdrängen. Ich erwarte, dass Wispr Flow, Willow Voice und Co. eher früher als später keine eigenständigen Start-ups mehr bleiben. Basismodelle werden austauschbar; OS-Hersteller integrieren dieselbe Funktion ohne Kosten.

„KI-gestützte Sprachdiktate“ nannte ich die Funktion bislang. Zukünftig sprechen wir wahrscheinlich nur noch schlicht von „Sprache“ und müssen dafür keine separate Einstellung aktivieren. Wie absurd wäre es, Maus und Tastatur vor jeder Nutzung zu aktivieren!?

Was für Gibberish ich manchmal diktiere und trotzdem verstanden werde, ist sicherlich noch faszinierender, wenn man aus dem Zeitalter von Dragon NaturallySpeaking kommt. Ich merke jedoch, wie ich Eigennamen und explizite Schreibweisen von Begriffen inzwischen unbewusst voraussetze.

Transkription ist weitgehend ein gelöstes Problem – das habe ich intellektuell akzeptiert. Das Ganze jedoch in Echtzeit und bereinigt von jedem Stottern sowie allen Füllwörtern und Pausen zu bekommen, bleibt faszinierend. So wird nicht nur mitgeschrieben, sondern interpretiert.

Ich vermute, dass diese Eingabemethode noch nicht spektakulärer erscheint, weil sie a) noch von zu wenigen Menschen genutzt und b) lediglich als reine Niederschrift verstanden wird – obwohl gerade das Sprachverständnis der entscheidende Sprung nach vorn ist.

  •  
❌